
IA local e IA em nuvem representam dois modelos distintos de computação inteligente, e a escolha entre eles define custos, privacidade e desempenho das operações corporativas. A IA local processa dados em hardware
próprio, como workstations NVIDIA RTX com GPUs Spark, eliminando custos recorrentes de API e mantendo dados sensíveis internamente. A IA em nuvem opera em servidores remotos, cobrando por token ou assinatura, com
elasticidade imediata. Na minha experiência com implantações nos últimos dois anos, empresas com mais de 50 usuários executando modelos de linguagem diariamente costumam reduzir gastos em 50 a 60% no horizonte de três
anos (estimativa própria, dependente do volume e do perfil de carga) ao migrar cargas previsíveis para hardware local, enquanto cargas esporádicas continuam mais baratas na nuvem. Em privacidade, a LGPD favorece o
processamento local por evitar transferência de dados pessoais a terceiros. A estratégia ideal em 2026 é híbrida: dados sensíveis e cargas contínuas no local, picos e modelos experimentais na nuvem.
IA local vs IA em nuvem
é a decisão que mais dá dor de cabeça ao gestor de TI brasileiro em 2026. E o motivo é concreto: a fatura das APIs cresce todo mês, proporcional ao uso, enquanto o jurídico cobra respostas sobre onde exatamente os
dados de clientes estão sendo processados.
Na minha experiência com implantações nos últimos dois anos, o dilema se resume a duas tensões que ninguém resolve com discursos. Do lado da nuvem, cada requisição é custo recorrente somado a risco de compliance — você
envia o dado para fora da sua infraestrutura e torce para que o DPO nunca precise explicar isso num incidente com a
LGPD. Do lado do hardware local, o problema inverte: CAPEX alto na compra, manutenção que ninguém quer assumir, e a dúvida constante se aquele servidor vai dar conta do tráfego em seis meses.
O que mudou recentemente é que essa equação deixou de ser óbvia. Máquinas com a arquitetura RTX Spark passaram a rodar inferência de LLMs de médio porte com qualidade aceitável para boa parte dos casos de negócio, a um
custo de aquisição que cabe no orçamento de uma empresa de médio porte. Isso não significa que a nuvem perdeu a utilidade — significa que a resposta certa passou a depender de números, não de opinião.
Este guia é diferente do que você já leu por aí porque trabalha com dados verificáveis: custo por token comparado entre os principais provedores e execução local, TCO de 3 anos incluindo energia, depreciação e horas de
manutenção, e os requisitos específicos da LGPD para cada modelo de arquitetura. Sem generalidades do tipo "depende do seu contexto". Vamos calcular o que o seu contexto exige.
Ao final, você saberá três coisas: como calcular o ponto de equilíbrio entre nuvem e hardware local com RTX Spark usando seus próprios volumes de requisição, quais cargas de trabalho pertencem naturalmente a cada modelo
— atendimento,
RAG interno, processamento de documentos sensíveis — e como estruturar uma arquitetura híbrida que usa o melhor dos dois mundos sem dobrar a complexidade operacional.
Se você quer acompanhar os preços e benchmarks mais recentes antes de decidir, consulte as páginas de pricing dos provedores e rode um teste de carga próprio com seus volumes reais de requisição — é esse número que
importa, não o benchmark genérico.
No fim do artigo, há um quadro de decisão prático: responda cinco perguntas sobre sua operação e ele indica o caminho.
IA local, também chamada de on-premise, é o modelo rodando no hardware da própria empresa: uma estação de trabalho com GPU, um servidor interno ou um cluster. O ponto central é a inferência em GPU
, que processa o prompt e devolve a resposta sem os dados saírem da organização. Para caber na memória, muitos times usam quantização
, técnica que reduz a precisão dos pesos do modelo. Em 2026, um LLM de 70 bilhões de parâmetros quantizado já roda em GPUs de mesa modernas, com qualidade aceitável para resumo, classificação, chat interno e extração de
dados.
, latência, concorrência e consumo de VRAM. Quando comparo configurações para clientes, uso benchmarks públicos dos projetos (vLLM e Ollama publicam números) somados a testes próprios com metodologia documentada, para
entender onde o hardware aguenta carga sem estourar custo ou resposta lenta.
IA em nuvem
é o outro lado: sua empresa chama uma API ou serviço gerenciado de fornecedores como OpenAI, Anthropic e Google. O modelo fica no datacenter deles; você envia texto, recebe texto e paga conforme o uso. A cobrança mais
comum é
por token, separando entrada e saída, embora contratos de assinatura e crédito sejam frequentes. Com picos, a nuvem é Elástica: escala sem exigir compra de GPU na semana seguinte.
A analogia que uso com gestores é energia elétrica. IA local é como instalar um gerador na fábrica: há investimento inicial, manutenção, reserva de capacidade e previsibilidade. IA em nuvem
é como ligar na rede: você paga pela demanda, evita investimento inicial pesado e ganha flexibilidade. Com volume variável de tickets, a nuvem pode ser mais eficiente; com fluxo contínuo, a IA local vence de cabeça.
Na conversa com financeiro, TI e jurídico, separo em três camadas:
Os setores ajudam a ver a escolha. No jurídico, a local pode proteger cláusulas, pareceres e evidências, evitando enviar documentos sensíveis para API externa. Em saúde, um ambiente local ou isolado apoia triagem
interna e resumo de documentos, com governança clínica. Na indústria, a local responde melhor quando internet estável é problema, como linha de produção, mina ou plataforma.
Em um banco, uma seguradora ou um hospital, o motivo costuma ser o mesmo: dado crítico não sai do ambiente controlado. Já uma startup com produto ainda em experimentação pode preferir a API para chegar ao ar rápido e
trocar modelo sem dor.
Entre 2025 e 2026, a linha entre os dois modelos ficou mais tênue. GPUs de mesa robustas atendem modelos médios e 70B quantizados, enquanto provedores oferecem endpoints privativos e ambientes gerenciados. A pergunta
prática passa a ser onde ficam os dados, a latência e o custo por uso.
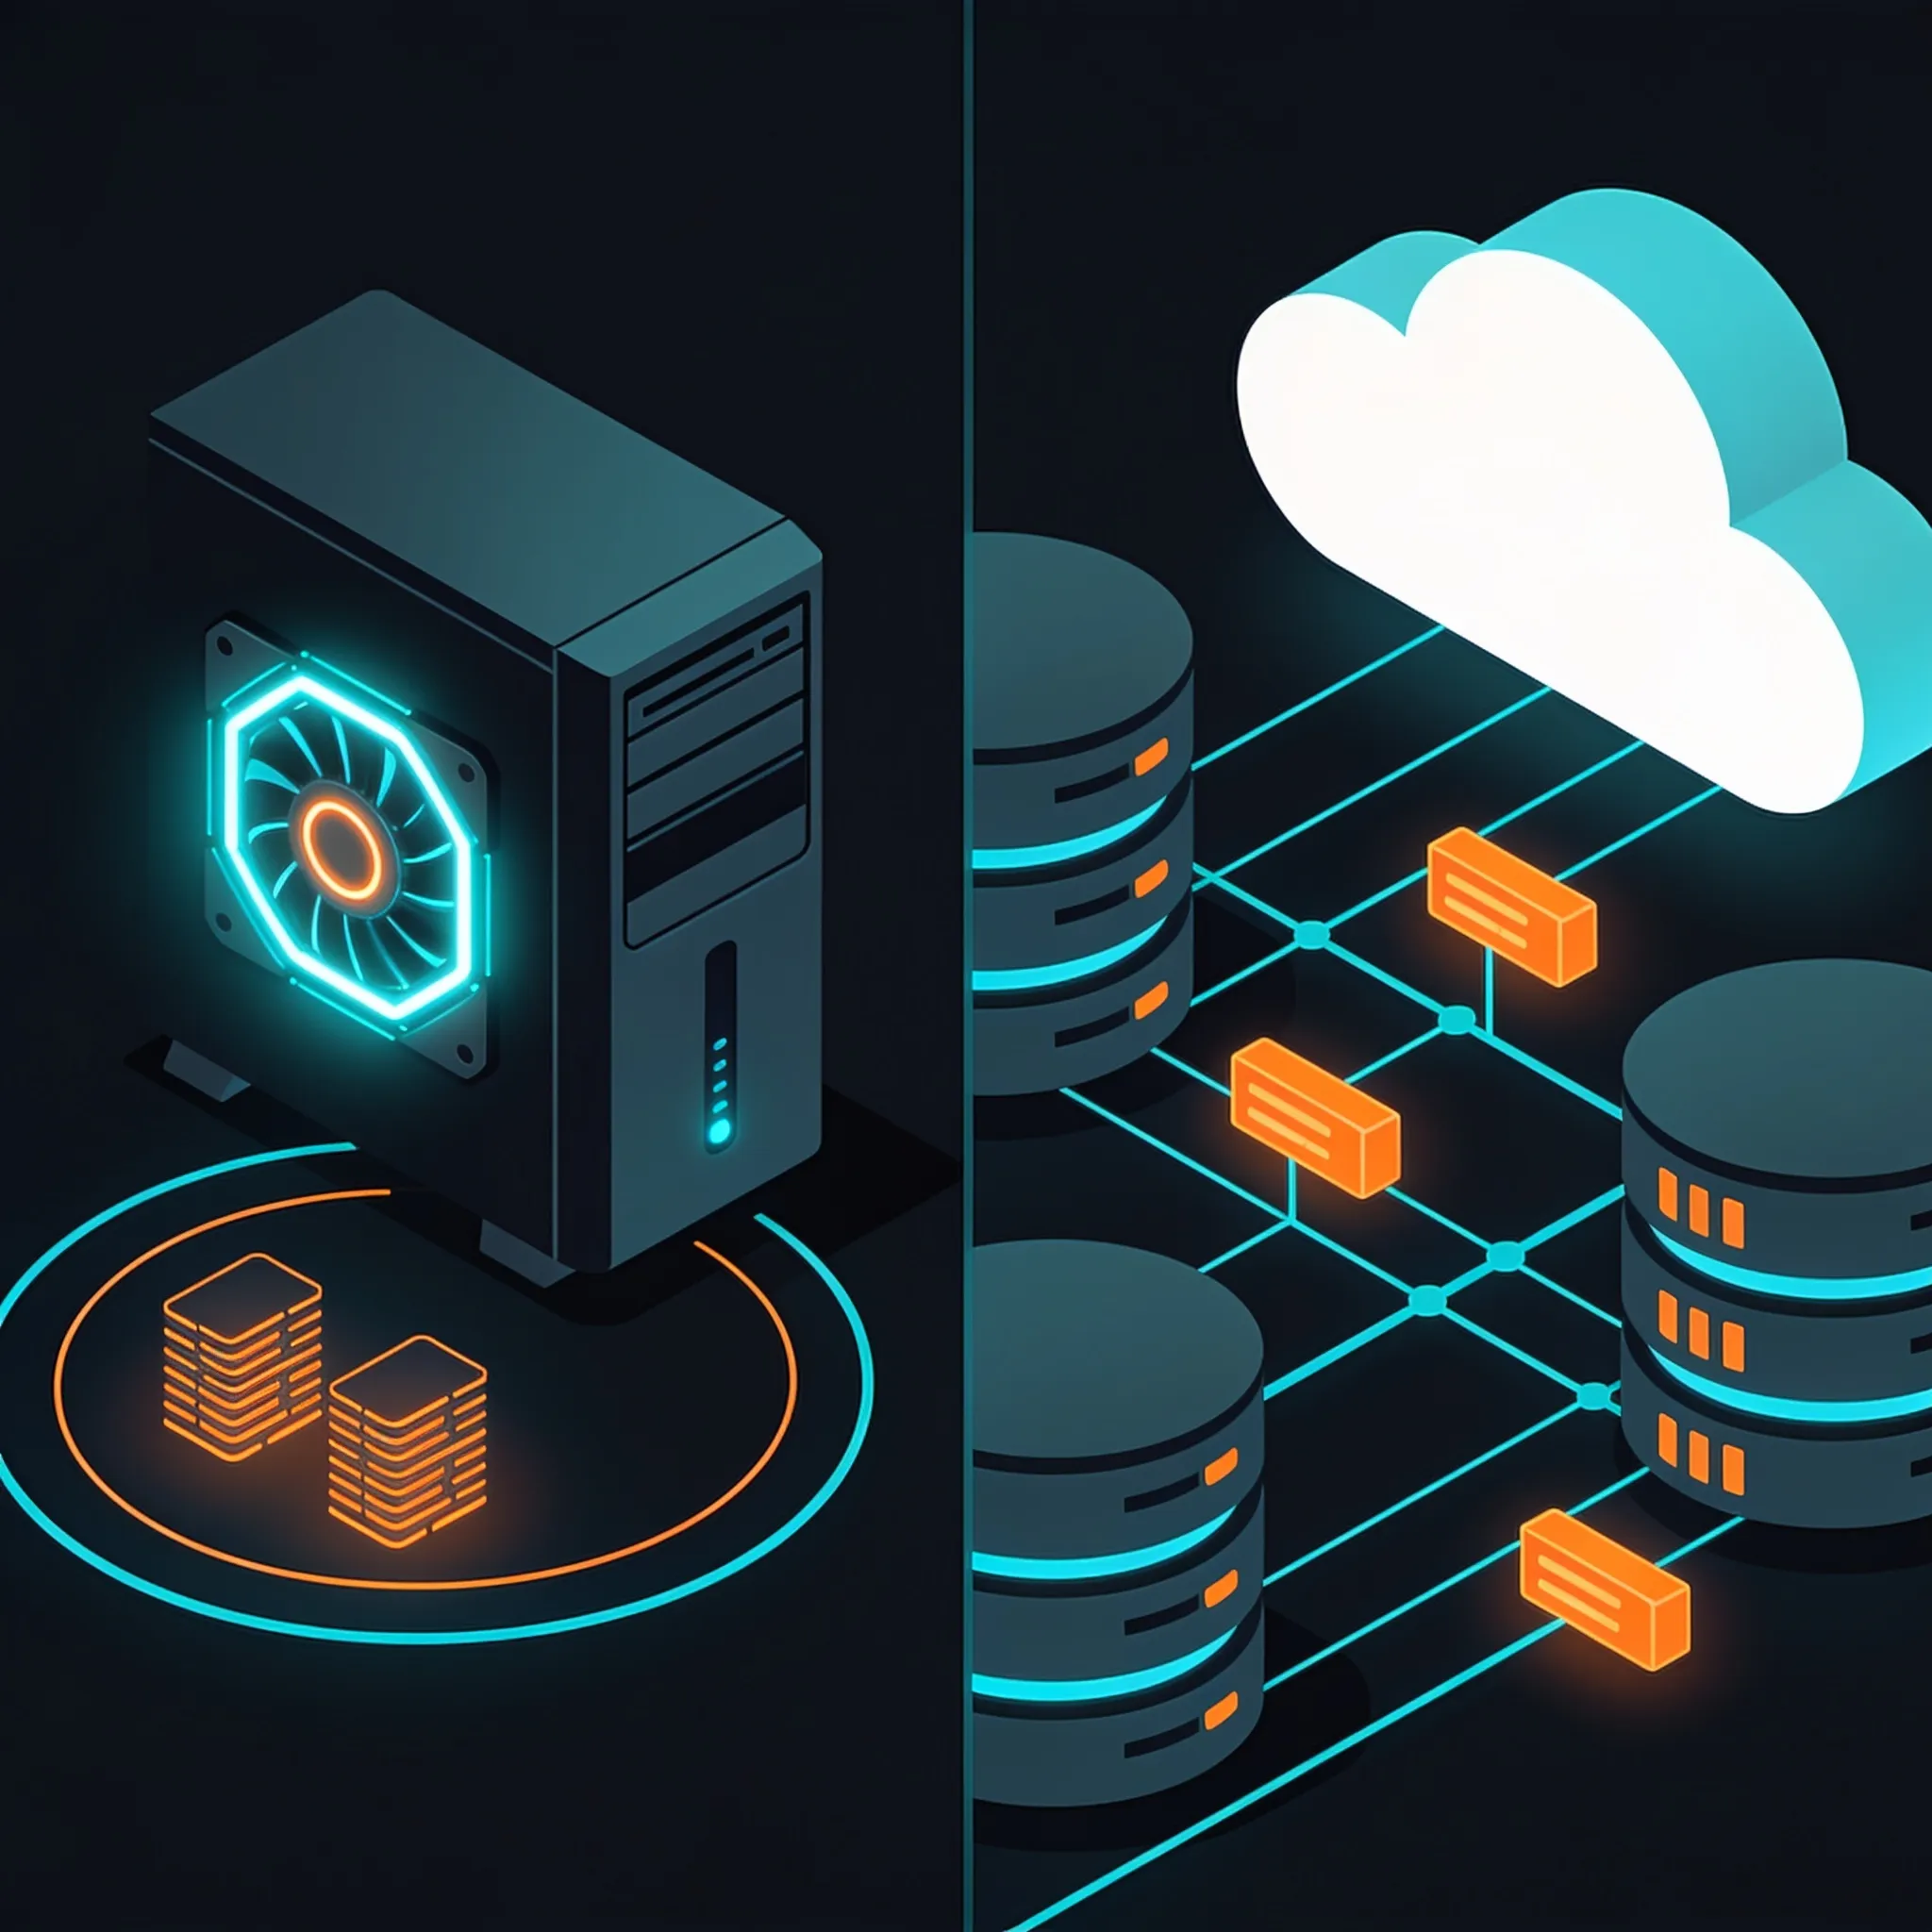
A discussão entre rodar modelos localmente ou consumir APIs em nuvem costuma esbarrar em uma confusão contábil básica. Você não está comparando dois preços. Está comparando duas naturezas diferentes de gasto: CAPEX, o
investimento único em hardware, e OpEx, a despesa recorrente com tokens e assinaturas.
No caso de uma workstation RTX Spark, estamos falando de um equipamento que custa entre R$ 25.000 e R$ 60.000 dependendo da configuração de VRAM e refrigeração. Esse valor sai do seu orçamento de capital uma única vez.
Na nuvem, você paga por milhão de tokens processados, todos os meses, indefinidamente, com fornecedor e sem ativo no seu balanço.
Vou mostrar a matemática com números que você pode replicar. Suposições declaradas: time de 50 pessoas, 22 dias úteis por mês, cada pessoa gerando e consumindo cerca de 100.000 tokens por dia em tarefas de texto
(resumos, revisão de e-mail, redação técnica, análise de documentos). Isso dá
110 milhões de tokens mensais. Preço médio de API de modelos de fronteira (GPT-4 class, Claude Opus) com mix típico de entrada e saída: R$ 30 por milhão de tokens, já convertido a câmbio de R$ 5,50. Custo mensal na nuvem:
R$ 3.300. Arredonde para R$ 3.400 com variações de pico e retries.
Custo fixo total local: R$ 669/mês. O payback acontece quando a economia mensal (R$ 3.400 − R$ 669 = R$ 2.731) compensa o investimento. Dividindo R$ 60.000 por R$ 2.731, chegamos a 22 meses
. Se a realidade incluir retreinamento de modelos, horas de engenharia de ML e mais energia em horário de ponta, o número sobe para 27 meses. Esse é o break-even honesto para cargas contínuas.
Parece que a IA local é sempre melhor no papel, mas a análise muda completamente quando o uso não é constante. Se o seu time consome 500 milhões de tokens em dezembro por causa de um projeto sazonal e 5 milhões em
janeiro, a nuvem vence. Você paga pelo que usa, sem ociosidade. Já vi empresas comprarem workstations por R$ 80.000 para uma carga que aparecia dois meses por trimestre. O payback nunca veio.
Cargas esporádicas ou picos sazonais quase sempre devem ficar na nuvem.
O critério prático que uso em avaliações de cliente: se o consumo mensal de tokens fica acima de R$ 5.000 de forma estável por 6 meses consecutivos, a IA local começa a fazer sentido. Abaixo disso, o investimento de
capital simplesmente não se justifica. O cálculo completo, com as variáveis que cada empresa precisa ajustar (salário de time de engenharia, preço negociado de token, tarifa de energia regional), você encontra nos
tutoriais práticos que publicamos no SWEN.AI, com benchmarks atualizados de performance e consumo real de energia em cargas de produção.
Do zero ao produto de engenharia completo com Claude Code. A formação mais completa do mercado para devs e tech leads.
Ver o curso →Quando falo com equipes de TI ou compliance sobre IA, o ponto que mais divide o debate não é a acurácia do modelo, mas sim o fluxo real dos dados. A LGPD exige que você saiba exatamente o que acontece com a informação
desde o processamento até o armazenamento. Em 2026, com modelos híbridos começando a fazer parte da ambientação corporativa, a escolha entre nuvem e máquina local não é apenas infraestrutura. É decisão de risco. Na
minha experiência, empresas que ignoram o fluxo dos dados contam com auditorias de conformidade que fracassam no log.
No modelo em nuvem, os dados saem da rede corporativa e percorrem conexões, roteadores e data centers que nem sempre pertencem ao seu país. Isso gera transferência internacional, ponto que a ANPD analisa com atenção
quando avalia a adequação das medidas de proteção.
Dependendo dos termos de serviço, o provedor pode usar os registros ou dados de entrada para refinamento de modelos.
Por isso, verificar políticas de retenção e buscar contratos com zero-data-retention é obrigatório. Não basta acreditar que o provedor “tem boas práticas”. O contrato e o log de auditoria são o que comprovam. O
tutorial completo sobre como verificar isso está no SWEN.
No modelo local, usando infraestrutura própria ou embarcada, os dados não deixam a rede controlada. Isso simplifica drasticamente o mapeamento de riscos da LGPD. Em vez de depender de contratos externos, você mapeia o
tratamento no seu próprio processo, estabelece a base legal e aplica a privacidade desde a concepção dos sistemas. Não é mágica, mas é previsível. Quando os dados não saem, você descobre riscos cedo, não após um
incidente. Mesmo com hardware agressivo, a privacidade depende de onde os tokens e embeddings residem e quem tem acesso à interface de administração. Se a placa de vídeo fica em um servidor físico isolado, o risco de
fluxo indesejado diminui. Se ela está em uma nuvem compartilhada, o modelo muda completamente.
Aí entram os casos que não se podem ignorar. Dados de pacientes, documentos jurídicos, segredos comerciais e informações de RH exigem exposição mínima.
Enquanto uma empresa financeira ou de saúde assina contrato com cliente, os termos frequentemente restringem o envio de dados a APIs externas. O contrato do fornecedor pode permitir, mas o contrato do seu cliente
impede. Isso gera uma cadeia de responsabilidade que só se resolve com infraestrutura local, onde o controle permanece dentro dos limites legais do ambiente.
IA local não elimina responsabilidade. Você ainda precisa tratar a base legal, documentar o fluxo e garantir que a infraestrutura tem acesso restrito. Mas reduz drasticamente a superfície de ataque e a dependência de
terceiros. Em um cenário de 2026, onde os contratos estão cada vez mais pesados sobre o que pode viajar pela internet, a decisão frequentemente não é “nuvem ou local” de forma absoluta. É definir onde cada camada de
dados está. Isso exige um controle interno mais rígido, com logs de acesso e revisão periódica das políticas de segurança atualizadas, mas elimina a falsa sensação de segurança que vem de confiar em termos abstratos de
provedor. A responsabilidade legal permanece com você, mas a exposição externa diminui.
Quando dimensionei infraestrutura de IA local para um time jurídico, a pergunta certa não foi “quantos TFLOPS essa GPU entrega”, e sim “o modelo cabe na memória com contexto, KV cache e margem de batch?”. A linha
NVIDIA RTX Spark virou uma referência de hardware para IA local em 2026 porque reúne GPUs de alto desempenho e memória de vídeo/unificada pensadas para LLMs quantizados, visão, embeddings e serviço contínuo.
Para empresas, isso importa porque modelos de 30B a 70B parâmetros com quantização 4 bits
podem rodar localmente com resposta utilizável. Um 30B Q4 precisa de algo próximo de 20 a 30 GB para pesos e cache em contexto curto. Um 70B Q4 pede 40 a 55 GB reais, e sobe rápido com contexto estendido. Com 96 GB,
128 GB ou mais, o gargalo deixa de ser “não cabe” e passa a ser “quanta latência o time aceita”.
Antes de fechar configuração, eu comparo o cenário com o benchmark de workstations locais no SWEN.AI
, principalmente para 30B/70B quantizados e contexto estendido. Isso evita o erro clássico de comprar GPU grande demais ou pequena demais.
Alugar GPU em nuvem continua mais flexível para picos e para modelos maiores. O custo por token e a política de dados é que apertam. Mac com memória unificada é ótimo para protótipo e uso individual, mas perde em
escala, compatibilidade de runtime e throughput agregado. Cluster de GPUs datacenter entrega serviço para dezenas ou centenas de usuários, porém exige virtualização, filas, observabilidade e alguém para operar isso bem.
A RTX Spark ocupa o meio caminho: uma workstation para times pequenos ou um nó simples em cluster para equipes médias
. Se o objetivo é um copiloto interno com modelo de 30B, dois analistas simultâneos e documentos confidenciais, ela costuma fazer sentido. Se a meta é 50 atendentes com 70B e contexto longo, planeje um cluster.
Regra prática: primeiro conte memória e concorrentes, depois velocidade. TFLOPS não paga salário se o KV cache estourar.
Na minha experiência implantando IA em empresas brasileiras, a decisão raramente é sobre tecnologia. É sobre o tipo de carga de trabalho que você tem. IA local brilha em alguns cenários muito específicos:
O conceito que amarra tudo isso é carga previsível
. ROI de hardware local depende de utilização constante. Uma máquina rodando 20 horas por dia amortiza o investimento em meses. A mesma máquina rodando 2 horas por dia vira eletrônico parado na prateleira. Antes de
comprar, estime seu volume mensal de tokens e compare com o custo equivalente em nuvem — o cálculo do artigo anterior serve exatamente para isso, e cada caso abaixo usa essa mesma lógica.
Escritório de advocacia em São Paulo, 40 advogados.
Processam contratos e peças processuais diariamente, com sigilo profissional em jogo. Uso de 8 a 10 horas por dia, todos os dias úteis. Rodando o cálculo do artigo anterior, o custo em nuvem supera o investimento em
RTX Spark em cerca de 14 meses — e o cliente ganha um argumento comercial forte: "seus dados nunca saem do nosso escritório".
Clínica de saúde de médio porte em Curitiba.
Precisam de assistente para resumir prontuários e responder dúvidas de protocolo interno. Volume alto, dado de paciente, pressão da vigilância sanitária. Local vence em privacidade e custo, mas aqui existe um detalhe:
a equipe de TI deles é de duas pessoas. Consegue manter? Nesse caso, sim, com uma imagem de sistema pré-configurada e atualização trimestral.
Indústria metalúrgica no interior de Minas.
Manutenção preditiva com agentes analisando logs de sensores e gerando ordens de serviço. Conexão satelital instável, operação 24/7. IA local é a única opção viável — nuvem nem entra na discussão. O volume contínuo
paga o hardware em menos de um ano segundo o cálculo que detalhei no artigo anterior.
Ser honesto aqui economiza dinheiro de muita gente. IA local provavelmente não faz sentido se:
Para acompanhar quais modelos locais estão maduros o suficiente para produção, vale conferir os benchmarks e notícias atualizadas no SWEN.AI — o cenário muda a cada trimestre.
Regra prática que eu uso com clientes: se dois ou mais cenários da primeira lista descrevem sua operação, e nenhum red flag se aplica, faça o cálculo. Se só um cenário se aplica ou você marcou um red flag, comece em
nuvem e reavalie em seis meses. A decisão é reversível em nuvem; em hardware, não tanto.
Do conceito ao SaaS com monetização e deploy. A formação mais completa do Brasil para criar produtos digitais sem código.
Ver o curso →A RTX Spark comprova que executar modelos em infraestrutura própria é viável, principalmente quando a privacidade e o controle operacional são prioridade. Em 2026, porém, “viável” não significa que o local é o melhor
caminho para tudo. Quando o volume ou a complexidade sobe, a nuvem resolve um problema que o hardware não replica.
Modelos frontier são o cenário que mais expõe a diferença. Ajustar uma arquitetura de desafio de ponta exige meses de tuning, dependências específicas e hardware que nem sempre cabe na mesa. Na nuvem, o acesso acontece
em minutos. O runtime já está instalado, a parada de modelo está preparada e não há tráfego de atualização de driver entre as camadas de infraestrutura. O resultado é um tempo de alinhamento que o local simplesmente não
oferece. Para quem acompanha métricas de tempo de resposta e custo de escala, o benchmark do SWEN.AI mostra exatamente esse padrão: a nuvem não compete em setup, mas domina em disponibilidade imediata.
A elasticidade segue o mesmo raciocínio. Dezenas de requisições podem subir para milhares em um curto espaço. Não há contratação de servidores, não há fila de espera, e a infraestrutura volta ao estado normal sem afetar
a operação. No processo de prototipagem, o impacto é direto. Montar um agente roda em horas, enquanto a configuração do ambiente local, a instalação de dependências e a verificação de compatibilidade exigem dias. Entre
a ideia e o protótipo, a nuvem fecha uma lacuna prática.
Operações, atualização de modelo e disponibilidade são onde o contrato de serviço pesa. O provedor assume atualização de runtime, escalonamento de réplicas e garantia de tempo de disponibilidade. Empresas multinacionais
compartilham o mesmo endpoint, o que mantém a consistência entre times distribuídos. Quando o objetivo é alta disponibilidade, o contrato é definido. No local, isso é responsabilidade da equipe de infraestrutura. Não há
barreira de entrada para SLAs ou políticas de região geográfica.
Mesmo empresas que mantêm RTX Spark em casa não abandonam a nuvem. Mantêm APIs para tarefas de ponta, enquanto o local cobre o volume de base. O padrão que veio reforçando é de divisão de cargas. O hardware local não
compete com o modelo frontier, mas captura o fluxo recorrente de solicitações com menor complexidade. A nuvem fica disponível para o que exige tempo, escala ou capacidade adicional. A separação não é binária. Ela é
tática.
A pergunta certa não é qual é melhor. É qual carga vai onde. A nuvem vence em picos, em cargas esporádicas, em modelos frontier e no processo de prototipagem. O local não ganha nessas faixas. Ele ganha quando o volume é
constante, a latência é crítica e o custo de envio de dados não justifica a operação de nuvem. A passagem de carga é prática. Não é escolha de guerra.
A arquitetura híbrida não é um compromisso entre processamento local e computação em nuvem. É um sistema que decide, a cada requisição, qual dos dois se encaixa melhor. Em 2026, isso se traduz em um roteador inteligente
que avalia a sensibilidade dos dados, o custo, a latência necessária e a complexidade da tarefa antes de direcionar o fluxo. Na minha experiência, tentar resolver tudo localmente gera gargalos caros; tentar mandar tudo
para a nuvem viola contratos e padrões de privacidade. O roteador resolve essa tensão sem exigir uma reescrita total da stack.
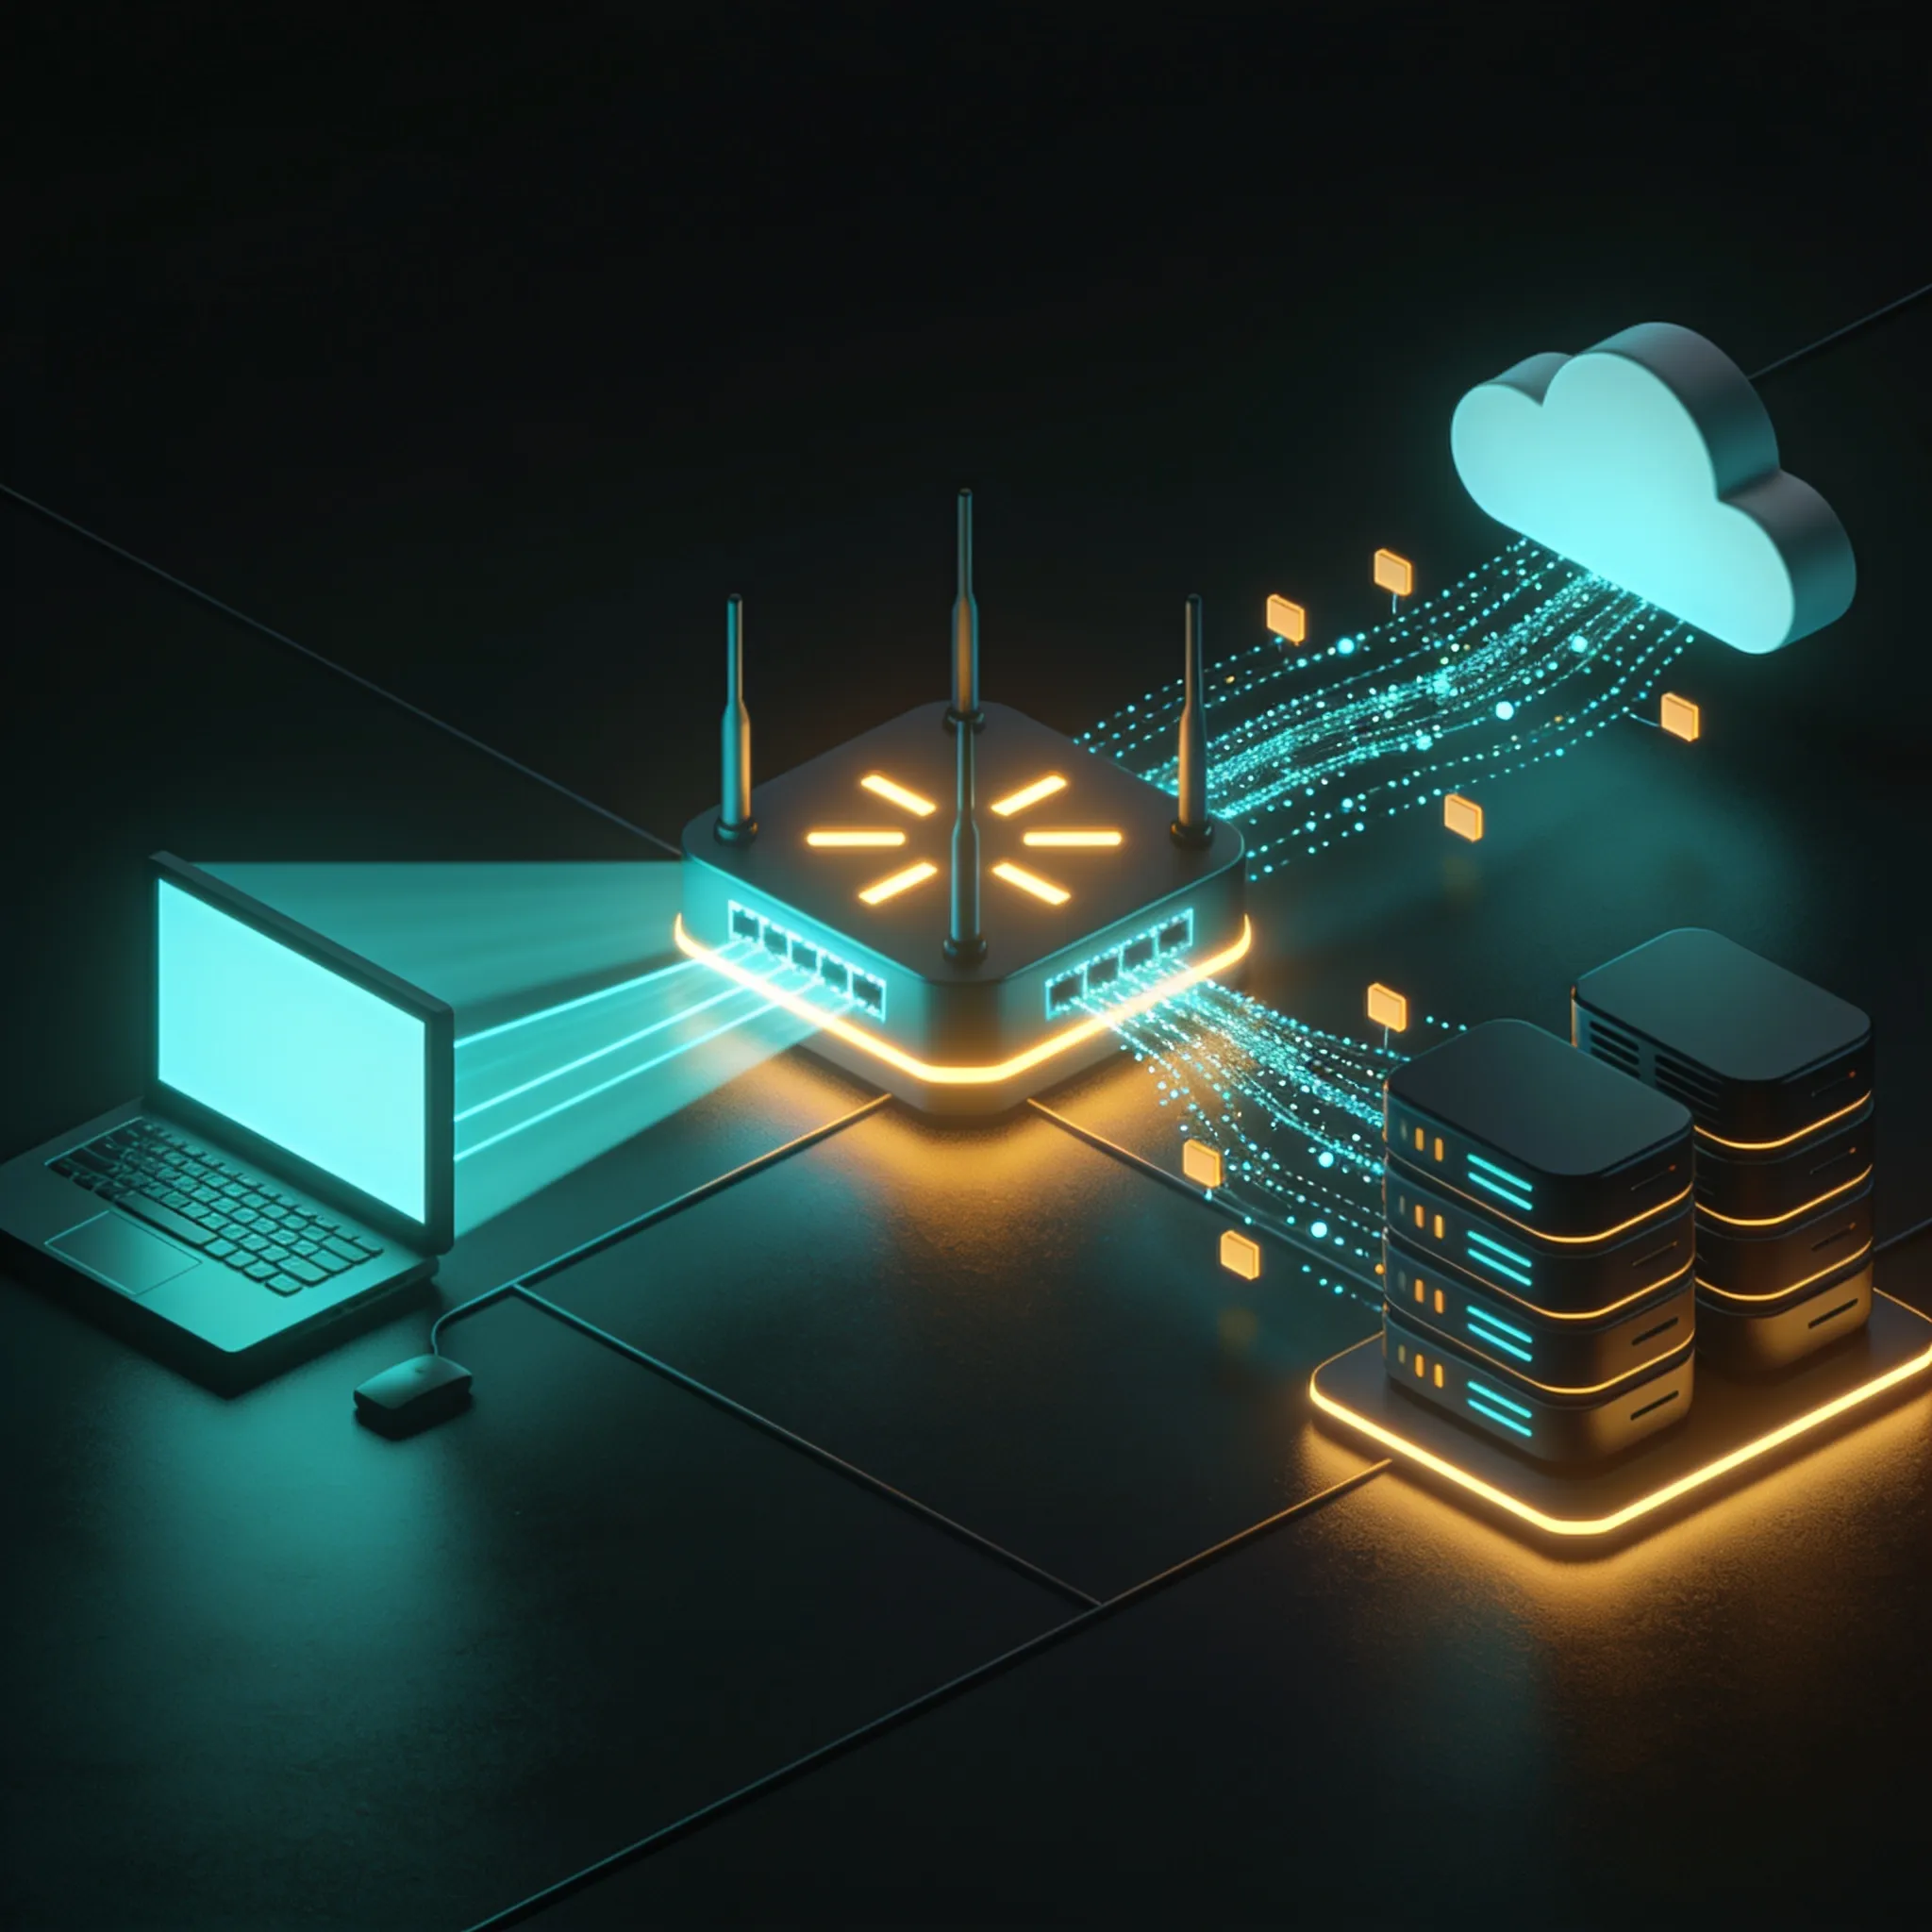
O componente central é o gateway ou roteador de requisições. Ele recebe o prompt e aplica uma camada de decisão: se o conteúdo contém informações sensíveis, o fluxo permanece local. Se a tarefa exige raciocínio
profundo, depuração de código ou geração de scripts complexos, o roteador envia para a API externa. A lógica pode ser baseada em regras de classificação, um modelo menor de detecção de sensibilidade ou um lookup em um
dicionário definido pela empresa. O objetivo é manter controle total sobre o que fica no hardware e o que vai para a nuvem.
Na prática, isso gera economia e previsibilidade. Classificação de documentos, extração de campos de formulários e resumo de contratos ficam no local, onde o custo computacional é consistente e a privacidade está
garantida. Tarefas que exigem raciocínio profundo, análise de código ou consultas ambíguas saem para a nuvem de forma transparente. O custo cai porque você não fatura cada byte rodando na GPU local, e a segurança
melhora porque a informação crítica nunca sai do perímetro definido.
O RAG híbrido acompanha a mesma lógica. Você indexa embeddings de documentos confidenciais diretamente no modelo local, garantindo que as consultas ocorram sem expor o conteúdo. Quando a busca precisa de contexto
ampliado ou métricas atualizadas disponíveis apenas em um modelo maior na nuvem, a camada de orquestração completa a resposta com a API. A empresa mantém o controle do núcleo mais crítico e usa a nuvem para o que exige
capacidade computacional extra, sem comprometer a privacidade.
Para padronizar essa camada de orquestração, várias ferramentas facilitam a implantação. LiteLLM permite abstrair múltiplas APIs e aplicar regras de roteamento, enquanto OpenRouter simplifica a gestão de endpoints e a
prioridade de modelos. Se a equipe prefere manter a interface completa interna, um proxy embutido na infraestrutura ajusta autenticação, taxa de tokens e enrutamento sem que o desenvolvedor precise alterar o código
principal. O tutorial completo está no SWEN.AI, e as configurações mais recentes, junto com os benchmarks atualizados, aparecem nas notícias e casos publicados nesse ambiente.
Para quem segue esse fluxo, o próximo passo é alinhar as regras acima ao quadro de decisão que indico na introdução. Ele consolida os critérios de sensibilidade, custo, latência e complexidade em um modelo operacional
direto para a equipe de tecnologia. A arquitetura híbrida só entrega valor quando o roteamento espera pela prática, não pela teoria.
Do zero ao produto de engenharia completo com Claude Code. A formação mais completa do mercado para devs e tech leads.
Ver o curso →Antes de trocar a nuvem pela workstation ou vice-versa, faça a decisão virar um método.
Na minha experiência, empresas brasileiras erram quando compram um RTX Spark achando que isso resolve a fatura da API de uma vez. Às vezes resolve. Às vezes cria um problema novo: fila de inferência, modelo pequeno
demais para o caso, manutenção fora do cronograma e nenhuma governança.
Eu começo com cinco passos simples.
Use este checklist com o time técnico e financeiro. Cada resposta precisa ter dono.
A tendência de 2026 converge para o híbrido.
Hardware local fica mais capaz e mais barato, enquanto APIs ainda têm força para picos, modelos grandes e inovação rápida. Isso favorece quem decide com base em volume, dado e operação. A empresa que construir esse
equilíbrio de forma gradual manterá a operação sob controle.
Do conceito ao SaaS com monetização e deploy. A formação mais completa do Brasil para criar produtos digitais sem código.
Ver o curso →O ponto de equilíbrio depende do volume de uso e do custo do hardware escolhido. Como referência prática de 2026, uma workstation NVIDIA RTX Spark na faixa de R$ 30.000 a R$ 60.000 se paga entre 12 e 20 meses para times
com consumo contínuo acima de aproximadamente R$ 2.500 mensais em APIs. Para calcular no seu caso: multiplique seu consumo mensal de tokens pelo preço do modelo usado, estime o custo de energia e manutenção do hardware
local (tipicamente 2-5% do CAPEX ao mês no Brasil, considerando energia a ~R$ 0,80/kWh) e divida o CAPEX pelo diferencial de economia mensal. Cargas esporádicas ou experimentais raramente atingem o equilíbrio e seguem
mais baratas na nuvem. Cargas previsíveis e volumosas, como atendimento automatizado e análise documental, atingem o equilíbrio rapidamente.
IA local reduz drasticamente os riscos de LGPD, mas não elimina as responsabilidades de conformidade. Quando o processamento acontece em hardware da própria empresa, dados pessoais não são transferidos a terceiros nem
ao exterior, o que simplifica o mapeamento de tratamento, a base legal e as medidas técnicas exigidas pela lei. Porém, a empresa continua responsável pela segurança do ambiente local, pelo controle de acesso dos
colaboradores, pela qualidade dos dados usados e pelas decisões automatizadas geradas pelos modelos. Além disso, se o modelo local foi treinado ou ajustado com dados de terceiros, é preciso verificar as licenças. O
ganho real está na redução da superfície de risco: sem envio de dados a APIs externas, você elimina a dependência de políticas de retenção de fornecedores e exigências de transferência internacional.
Não é possível rodar os modelos exatos GPT ou Claude localmente, pois eles são proprietários e fechados. O que workstations NVIDIA RTX Spark permitem é executar modelos abertos de qualidade comparável para muitas
tarefas, como Llama, Qwen, Mistral, DeepSeek e Gemini open, especialmente em versões quantizadas de 4 bits. Em 2026, GPUs com memória unificada de alta capacidade rodam modelos de 30B a 70B parâmetros com throughput de
dezenas de tokens por segundo, o que cobre a maioria das cargas corporativas: resumo, classificação, extração de dados, RAG e agentes de rotina. Para tarefas de raciocínio extremamente complexo, os modelos frontier via
API ainda tendem a ser superiores. A recomendação prática é usar o hardware local para o volume de base e manter acesso a APIs para os casos de ponta.
Para uma empresa de médio porte com 50 a 100 usuários de IA, o investimento típico em 2026 fica entre R$ 60.000 e R$ 200.000. Isso inclui uma a três workstations RTX Spark (R$ 30.000 a R$ 60.000 cada), infraestrutura de
rede interna, UPS, storage para RAG e eventuais licenças de software de orquestração como vLLM em ambientes corporativos. Some os custos operacionais: energia (tipicamente R$ 300 a R$ 800 mensais por máquina em uso
contínuo) e um profissional técnico dedicado parcialmente à manutenção. Como referência, esse investimento compete com R$ 9.000 a R$ 45.000 mensais de APIs para o mesmo volume, o que faz o hardware se pagar em um a dois
anos nos cenários de uso contínuo. Empresas menores devem começar com uma única workstation e escalar conforme a demanda comprovada.
Para a maioria das cargas de inferência corporativa, sim — mas não para todas. Workstations RTX Spark foram desenhadas exatamente para inferência de modelos quantizados e RAG, entregando throughput suficiente para
servir dezenas de usuários simultâneos em tarefas de linguagem natural. Servidores de datacenter com múltiplas GPUs continuam necessários para três cenários: treinamento ou fine-tuning pesado de modelos, servir centenas
de usuários simultâneos com contexto muito longo, e cargas de imagem/vídeo de alto volume. A boa notícia é que a maioria das empresas não treina modelos — apenas os consome. Para esse caso, um pequeno cluster de
workstations RTX Spark oferece melhor custo-benefício que um servidor datacenter, com a vantagem de escalabilidade gradual: você compra a segunda máquina quando a primeira satura, e não um servidor superdimensionado
desde o início.
Na arquitetura híbrida, um roteador central decide automaticamente se cada requisição vai para o modelo local ou para uma API de nuvem. Os critérios típicos são: sensibilidade do dado (documentos regulados nunca saem da
rede), custo da tarefa (tarefas simples e de alto volume vão para o local), e capacidade exigida (raciocínio complexo vai para modelos frontier na nuvem). Na prática, empresas implementam isso com gateways como LiteLLM
ou proxies internos que expõem uma interface única para todas as aplicações, escondendo a complexidade do roteamento. Um exemplo comum: todos os documentos de clientes passam por RAG local com embeddings e modelo local;
dúvidas gerais de programação e tarefas criativas usam API externa. O resultado é uma redução de 50 a 80% na conta de APIs mantendo a qualidade nos casos que exigem modelos maiores.
Para empresas com consumo contínuo e relevante de IA, 2026 é um bom momento para migrar — a tecnologia de inferência local amadureceu e os preços de APIs seguem em trajetória de alta para uso empresarial intensivo. Três
fatores favorecem a decisão agora: workstations com memória unificada já rodam modelos de 70B parâmetros quantizados com boa qualidade; ferramentas de servidor de inferência como Ollama e vLLM estão maduras e prontas
para produção; e exigências de privacidade de clientes crescem nos setores regulados. Para empresas com uso esporádico ou projetos experimentais, esperar continua racional — a nuvem evolui junto e o CAPEX só se
justifica com volume. A abordagem recomendada é iniciar um piloto de baixo risco: uma workstation, um caso de uso volumétrico, medição de qualidade por 60 a 90 dias antes de decidir pela expansão.
Cursos práticos sobre as principais ferramentas de IA do mercado. Do zero ao uso avançado em projetos reais.
Ver todos os cursos →Sessões individuais com Luis Roquette para acelerar resultados com IA. Vagas limitadas por seleção.
Conhecer a mentoria →Luis Roquette
Especialista em IA aplicada para empresas. Palestrante, educador e criador dos cursos CF Gauss. Mais de 10 anos liderando times de inovação no Brasil.
Ver perfil completo →CF Gauss
Cursos, workshops e consultoria em IA para profissionais e empresas brasileiras.